
Hasta ahora hemos ignorado las defensas empleadas por los desarrolladores web para defenderse contra las vulnerabilidades de subidas de archivos. Desde ahora miraremos algunos de los mecanismos de defensa usados para prevenir la subida de archivos maliciosos y cómo circunvalarlos.
Primero, veamos las diferencias entre filtrado del lado del cliente y del lado del servidor.
Cuando hablamos sobre que un script sea "Client-Side", en el contexto de las aplicaciones web, nos referimos a que corre en el navegador del usuario en vez de en el propio servidor. JavaScript es prácticamente omnipresente como lenguaje de scripting del lado del cliente aunque existen alternativas. Sin importar el lenguaje, un script del lado del cliente se ejecuta en el navegador. En el contexto de la subida de archivos, esto significa que el filtrado ocurre antes de que el archivo siquiera se suba. Debido a que el filtrado ocurre en nuestro ordenador, es relativamente trivial bypassearlo.
Por el contrario, un script "Server-Side", correrá del lado del servidor. Tradicionalmente, PHP era el lenguaje predominante del lado del servidor. Sin embargo, en los últimos años, otras opciones como C#, Node.js, Python, Ruby y más, se han empezado a usar ampliamente. El filtrado del lado del servidor tiende a ser más complicado de bypassear ya que no tienes el código delante de ti. Por lo general, tendremos que formar un payload que conforme con los filtros pero que nos siga permitiendo ejecutar nuestro código.
Con esto en mente veremos algunos diferentes tipos de filtros.
Extension Validation
Las extensiones se usan (en teoría) para identificar los contenidos deun archivo. En la práctica son muy fáciles de cambiar, por lo que no significan mucho. Sin embargo, MS Windows los utiliza para identificar tipos de archivos, aunque los sistemas UNIX confían en otros métodos. Los filtros que comprueban las extensiones funcionan de una de dos maneras:
- Meten aquellas extensiones especificadas en una lista negra (blacklist).
- Meten aquellas extensiones especificadas en una lista blanca (whitelist).
File Type Filtering
De forma similar, pero más intensiva, este tipo de filtro busca verificar que los contenidos del archivo son aceptables para subir. Veremos doos tipos de validación de archivos:
-
Validación MIME: Los tipos MIME (Multipurpose Internet Mail Extension) se usan como un identificador para archivos. Originalmente cuando eran transferidos como archivos adjuntos por email, pero ahora también cuando los archivos son transferidos por HTTP(S). El tipo MIME de un archivo subido está adjunto en la cabecera de la petición y se ve así:
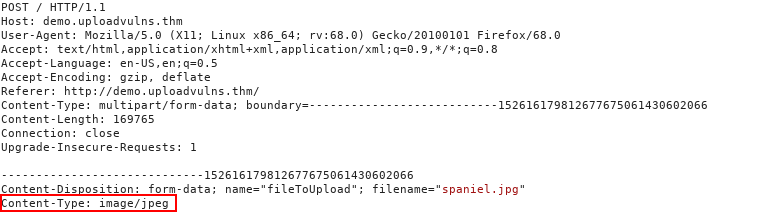
Los tipos MIME siguen el formato
<type>/<subtype>. En la petición de arriba, puedes ver que la imagen "spaniel.jpg" se subió al servidor. Como es una imagen JPEG legítima, el tipo MIME para esta subida es "image/jpeg". El tipo MIME para un archivo puede ser comprobado del lado del cliente y/o del servidor. Sin embargo, como MIME está basado en la extensión del archivo, es extremadamente fácil de sobrepasar. -
Validación Magic Number: Los magic numbers son una forma más precisa de determinar los contenidos de un archivo. Aqunue no son imposibles de falsificar. El "magic number" de un archivo es una string de bytes al comienzo del contenido que identifica el contenido. Por ejemplo, un archivo PNG tendría estos bytes arriba del archivo:
89 50 4E 47 0D 0A 1A 0A.
Al contrario que Windows, los sistemas UNIX usan magic numbers para identificar archivos. Sin embargo, al lidiar con archivos subidos, es posible comprobar los magic numbers en el archivo subido para asegurar que es seguro de aceptar. Esto no es ni de cerca una solución garantizada pero es más efectiva que la de arriba.
File Length Filtering
Los filtros de longitud se usan para prevenir archivos gigantes de ser subidos al servidor via formulario de subida (ya que puede causar starvation a recursos del servidor). Esto no será un problema normalmente al subir shells. Sin embargo, cabe tener en mente que si se espera un archivo muy pequeño puede llegar a serlo.
File Name Filtering
Como ya hemos mencionado, los archivos subidos a un servidor deberían de ser únicos. Esto suele significar añadir algún aspecto random al nombre del archivo. Sin embargom una estrategia alternativa sería comprobar si un archivo con el mismo nombre ya existe en el servidor y dar un error si así es. Además el nombre de los archivos debería ser sanitizado para asegurar que no contienen caracteres "malos" que podrían causar problemas en el sistema de ficherors al subirse (null bytes, caracteres de control como ;, etc.).
Si esto ocurre en un sistema, es probable que la shell que subiste no tenga el mismo nombre que antes de subirla.
File Content Filtering
Sistemas de filtrado más complejos pueden escanear el contenido entero de un archivo subido para asegurar que no está suplantando la extensión, tipo MIME o Magic Number. Es un proceso bastante más complejo que el de la mayoría de sistemas de filtrado que hay, por lo que no lo cubriremos en esta tarea, pero existen.
Es importante dejar claro que ninguno de estos filtros es perfecto en sí mismo. Normalmente serán usados en conjunto, ofreciendo un filtro de múltiples capas. Cualquiera de estos puede ser aplicado del lado del cliente, del servidor o ambos.
Además, diferentes frameworks y lenguajes vienen con sus propios métodos de filtrado y validación de archivos subidos. Como resultado, es posible que aparezcan exploits de lenguajes específicos, por ejemplo, hasta la versión 5 de PHP era posible bypassear el filtro de extensión mediante el null byte (%00) seguido de una extensión válida.